AI 口型同步音乐视频
使用 AvatarCraft AI 对齐歌曲、人声、嘴型和面部动作,制作逼真的音乐视频片段。专为需要超越普通“说话照片”口型同步效果的创作者打造。
为什么演唱口型同步比说话口型同步更难
节奏感知嘴型
说话时的口型同步可以跟随音节,但 AI 音乐视频口型同步还必须兼顾节拍、休止符、弱起和速度变化。如果嘴巴在歌词处张开却没对上节拍,观众会立刻察觉到违和感。
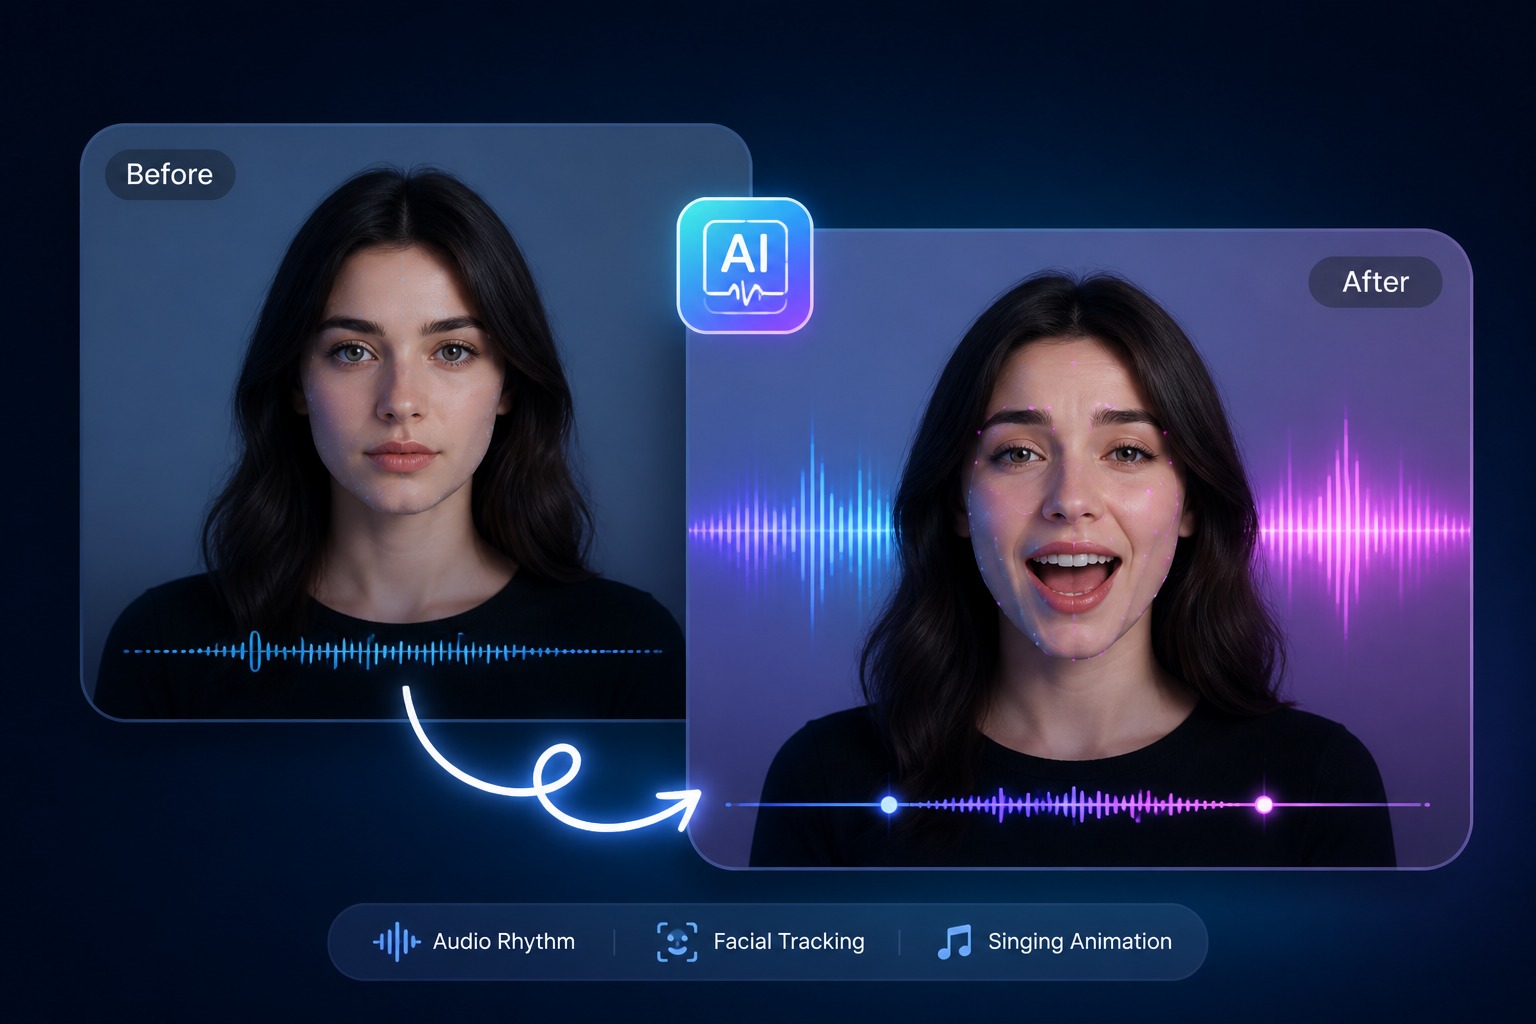
长元音控制
歌曲中元音的拉长方式是日常说话中罕见的。歌曲口型同步生成器必须在长音处保持张嘴状态而不使面部僵硬,并在下一个辅音出现前自然闭合。
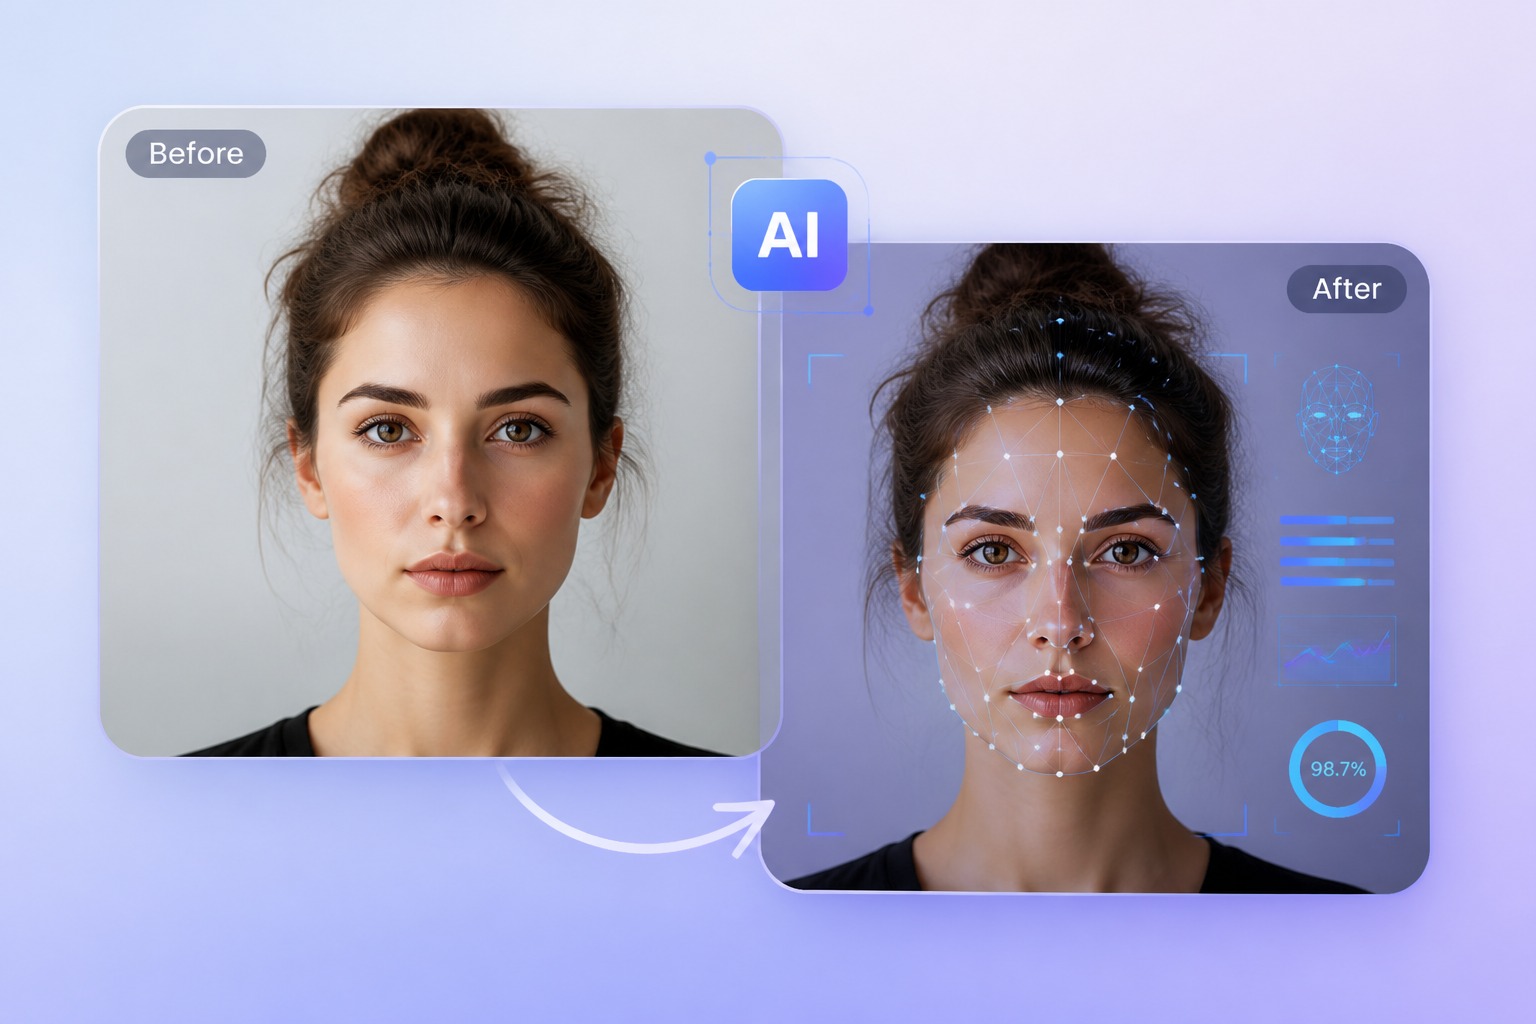
副歌时间校准
副歌通常会重复副歌旋律,因此时间误差也会重复。AvatarCraft AI 在创作者先测试短小副歌片段、检查偏差后再扩展到更长的自动口型同步视频时效果最佳。
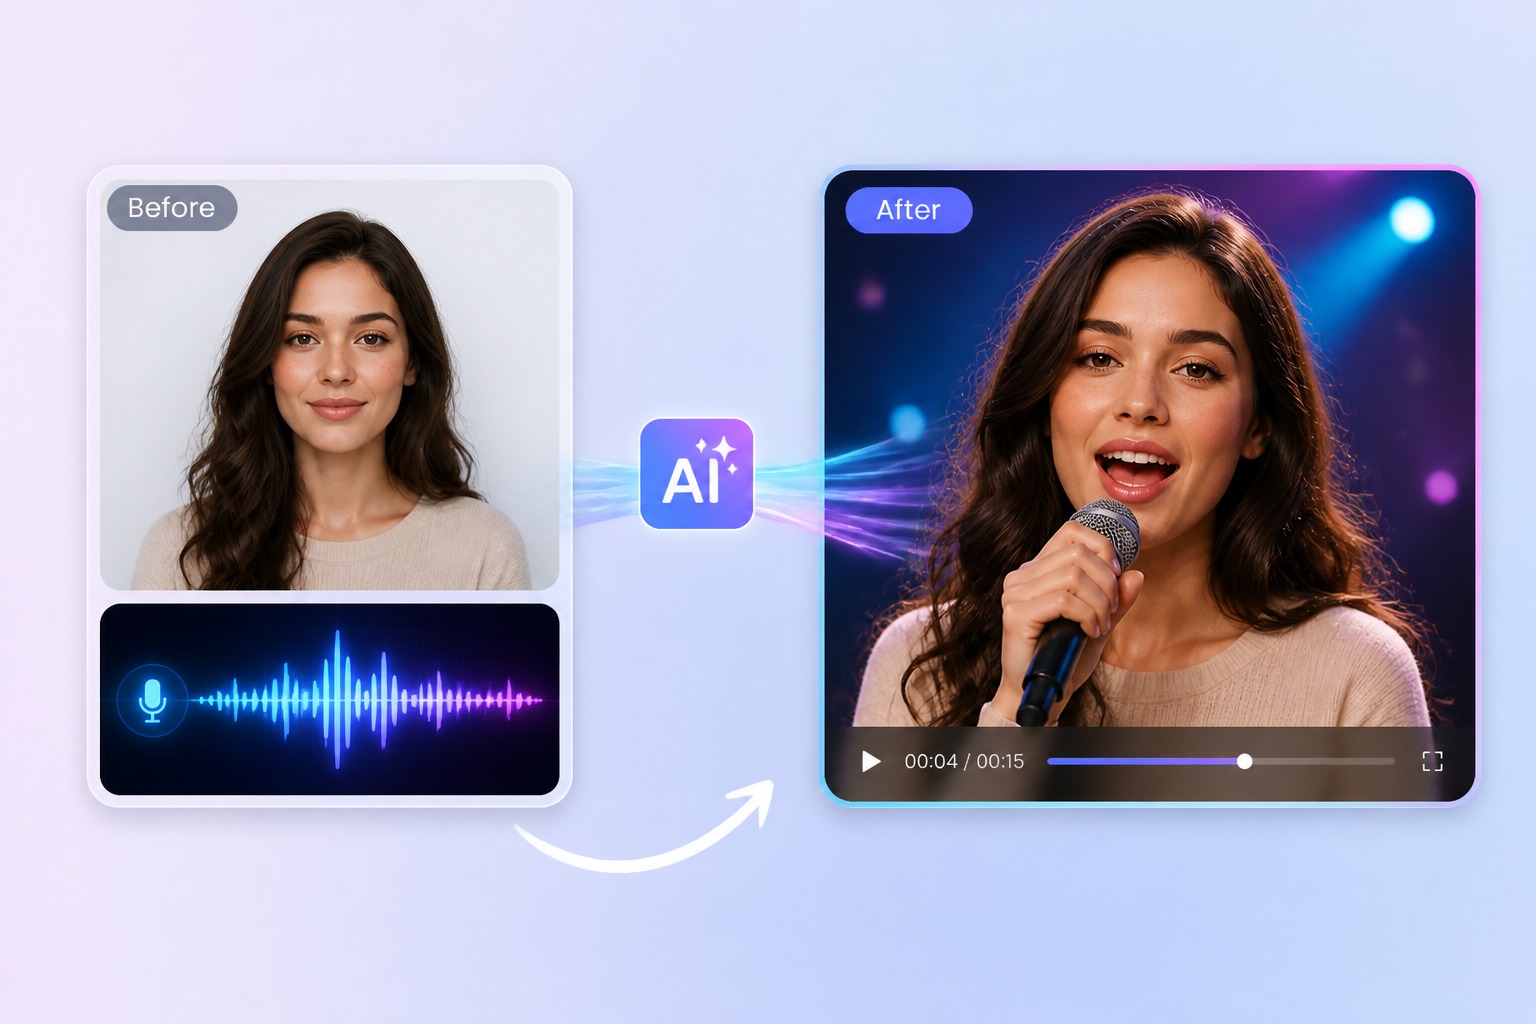
音乐视频工作流程
使用此页面进行同步精度调整。如需完整的创意制作,请继续前往 [AI 音乐视频生成器](/ai-music-video-generator)。如需更广泛的 AvatarCraft 工作流程,请使用 [AI 演唱虚拟人](/ai-singing-avatar) 模块。
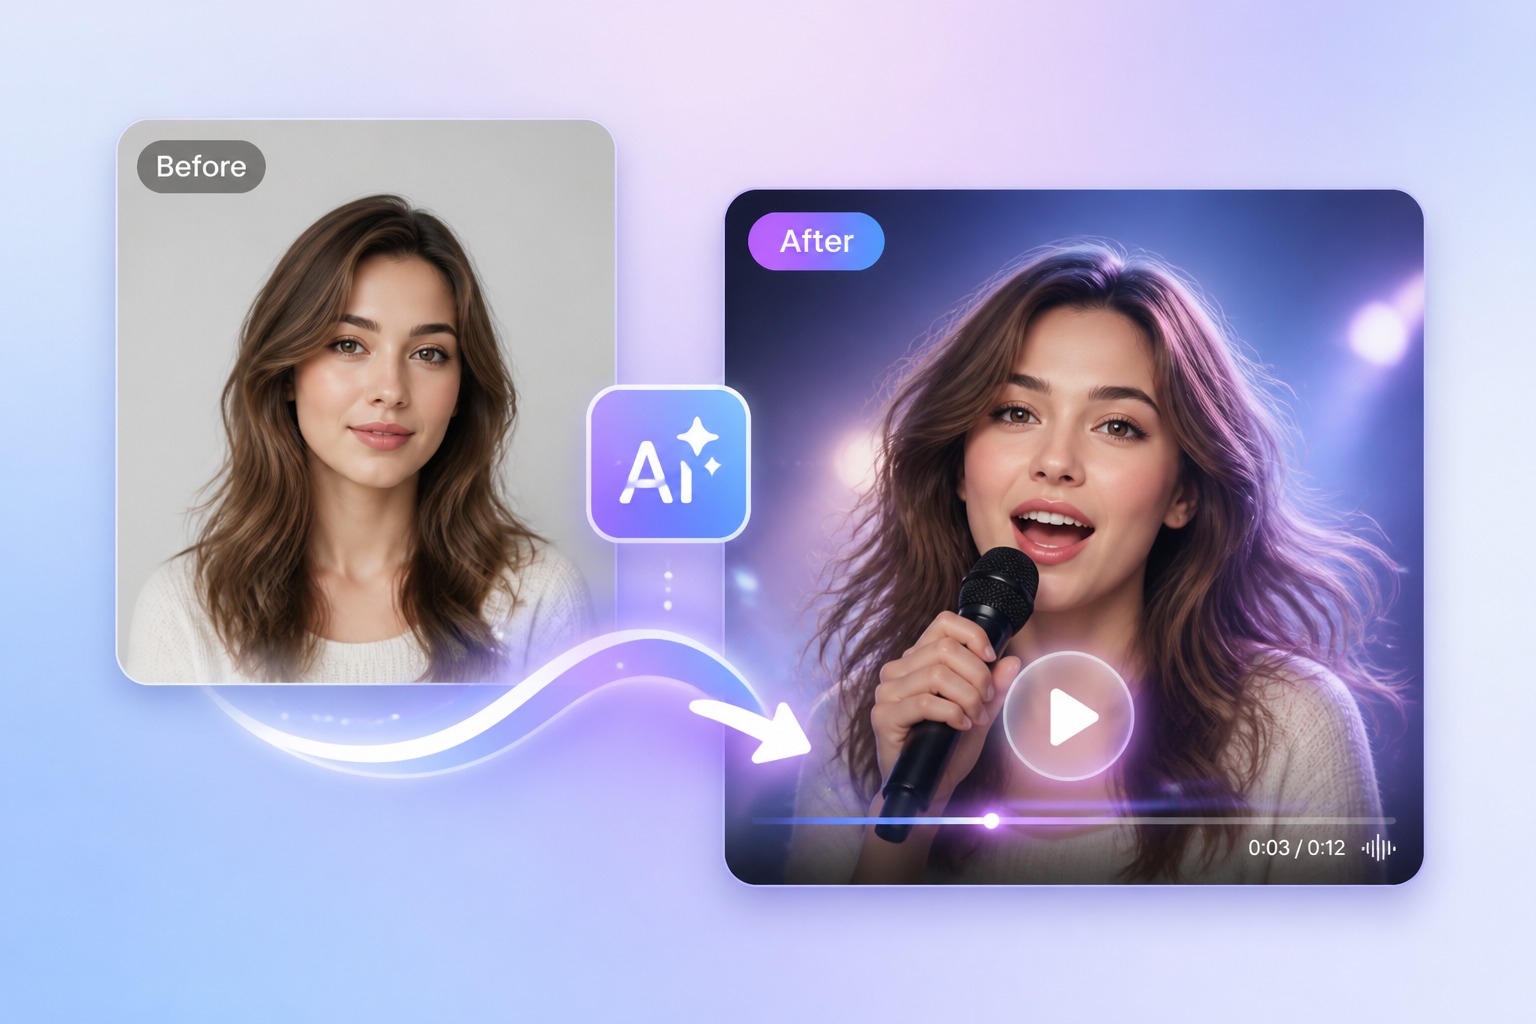
是什么让口型同步看起来帧级精准
音频到嘴部的对齐
人声应驱动嘴部的张开、闭合和过渡,而不是使用通用的说话动作。
面部动作连续性
在嘴部跟随歌曲的同时,眨眼、脸颊、下颌和头部动作需要保持自然生动。
短小副歌测试
副歌预览比完整渲染能更快发现偏差,并节省重新渲染的时间。
输入图像清晰度
当面部朝向正面且嘴部区域清晰可见时,图像转口型同步视频的效果会更好。
辅音时间控制
快速歌词需要干净利落的辅音闭合;否则即使元音看起来很流畅,片段也会给人一种滞后的感觉。
版权合规音频
当视频用于公开或商业用途时,请使用原创、已授权或免版税的音乐。
自动音频转口型同步视频流程
音乐视频技术同步的三个步骤
- 01
上传面部素材
从清晰的肖像或源片段开始。对于图像转口型同步视频,请使用一张面部清晰、嘴部、下颌线、眼睛和脸颊无遮挡的照片。
- 02
添加音乐音频
上传清晰的人声或歌曲片段。将首次测试修剪为副歌、高潮部分或 15 到 30 秒富有表现力的片段,以便轻松检查时间同步问题。
- 03
生成与审阅
创建自动口型同步视频,然后在导出前检查节拍时序、长元音、辅音闭合、面部动画及相似度。
用于音乐视频同步的 AI 面部动画
使用生成器处理简短且可控的音乐片段,让同步效果本身成为视频亮点:如副歌、翻唱、虚拟形象表演和社交媒体预览。
AI 口型同步音乐视频常见问题解答
什么是 AI 口型同步音乐视频?
AI 口型同步音乐视频是一种通过生成技术,使人脸动画与歌曲或人声轨道相匹配的视频片段。音乐 AI 口型同步生成器必须遵循节奏、长元音、快速歌词转换、副歌重复以及与表演相符的面部表情变化。
歌曲口型同步生成器是如何工作的?
歌曲口型同步生成器会分析音频时序,估算歌词和元音的口型,然后驱动面部动画以匹配这些提示。高质量的输出取决于清晰的人声、清晰可见的面部,以及在渲染较长音乐视频片段前进行简短的审阅。
为什么歌唱口型同步比说话口型同步更难?
歌唱会拉长元音、压缩快速辅音、重复副歌模式,并经常随节拍改变表情。说话模型可能在正确的词汇处张合嘴巴,但音乐口型同步 AI 还必须在节奏上保持准确。
我可以使用音频自动生成口型同步视频吗?
可以。自动音频转口型同步视频是核心工作流程:提供人脸素材和歌曲或人声轨道,然后让模型生成动作。由于快速歌词、嘈杂的人声和情感表达可能会导致时序问题,建议您仍需对输出结果进行审阅。
我可以用肖像照创建图像转口型同步视频吗?
可以,图像转口型同步视频在正面肖像照上效果最佳,此时嘴巴、下颌线、脸颊和眼睛清晰可见。侧面轮廓、遮挡的嘴部、严重的模糊和强烈的阴影会增加实现逼真口型同步的难度。
AI 能创造完美的口型同步吗?
没有任何工具能保证在每个音乐视频中都实现完美的口型同步。最出色的效果源于清晰的音频、清晰的人脸、简短的歌曲片段以及人工审阅。请将完美的口型同步视为目标标准,而非对每次输入的必然保证。
什么让口型同步看起来逼真?
逼真的口型同步不仅仅是嘴巴张合。它还包括辅音闭合、长元音保持、脸颊运动、眨眼、下颌动作以及情感契合度。如果嘴巴动作准确但面部其余部分僵硬,视频依然会显得不自然。
我应该检查哪些音频权利?
发布音乐口型同步视频时,请使用原创、已获授权或免版税的音频。对于商业用途,还需确认所动画的图像、肖像、虚拟形象或角色的相关权利。准确性不能替代授权。