—Cost: —
AI 口型同步
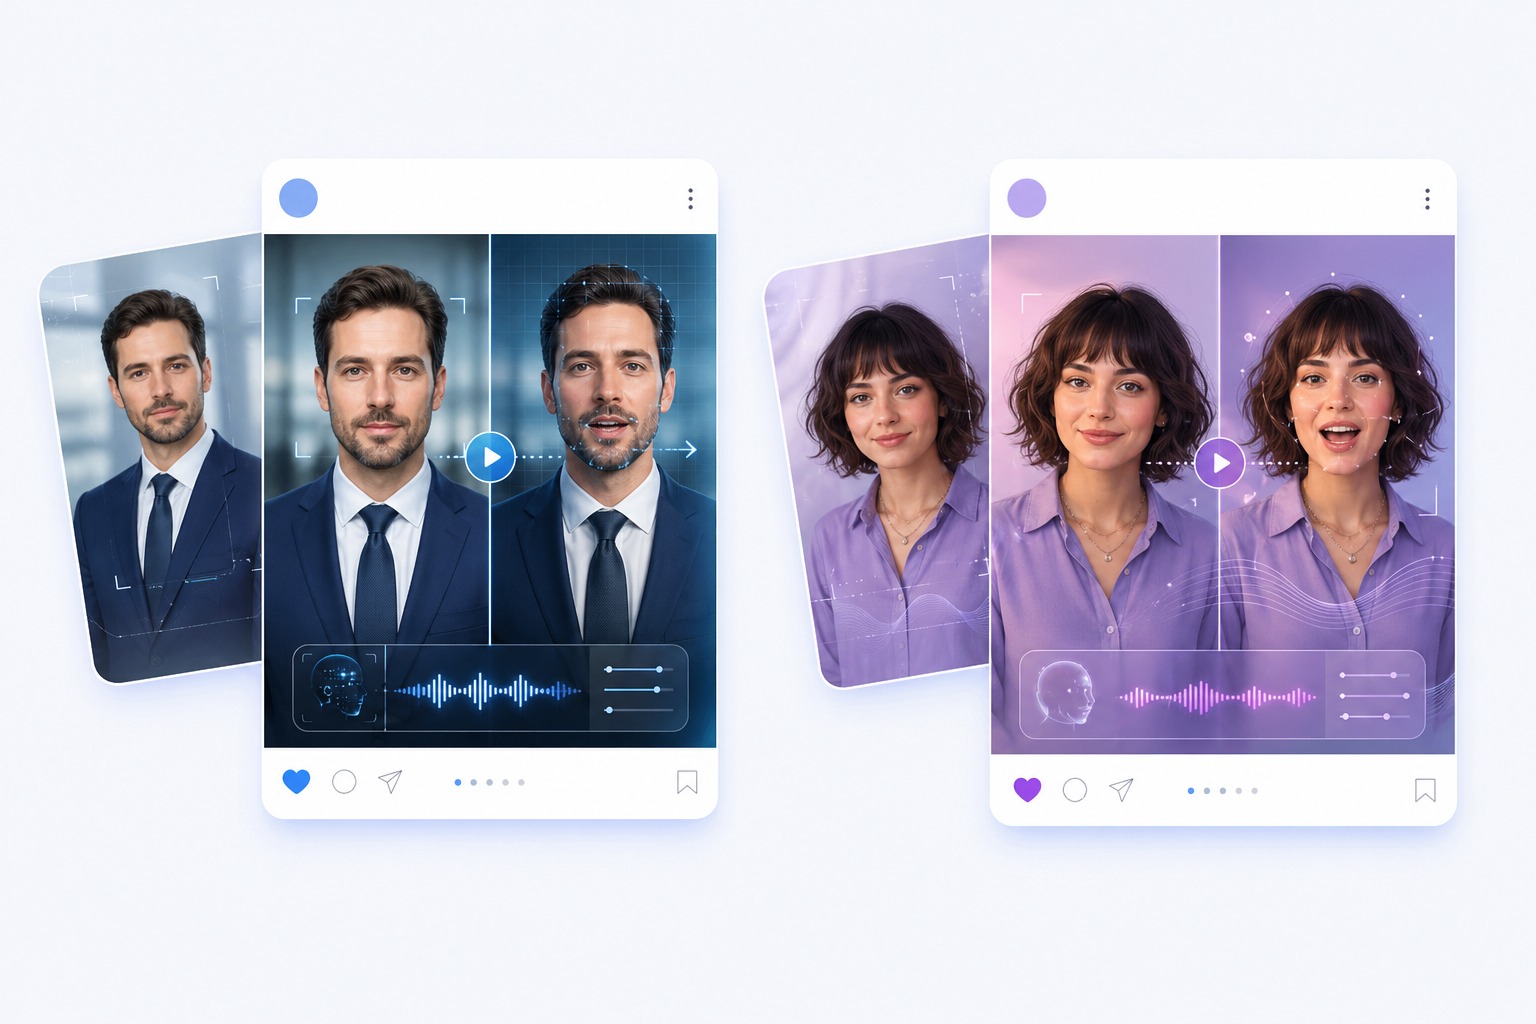
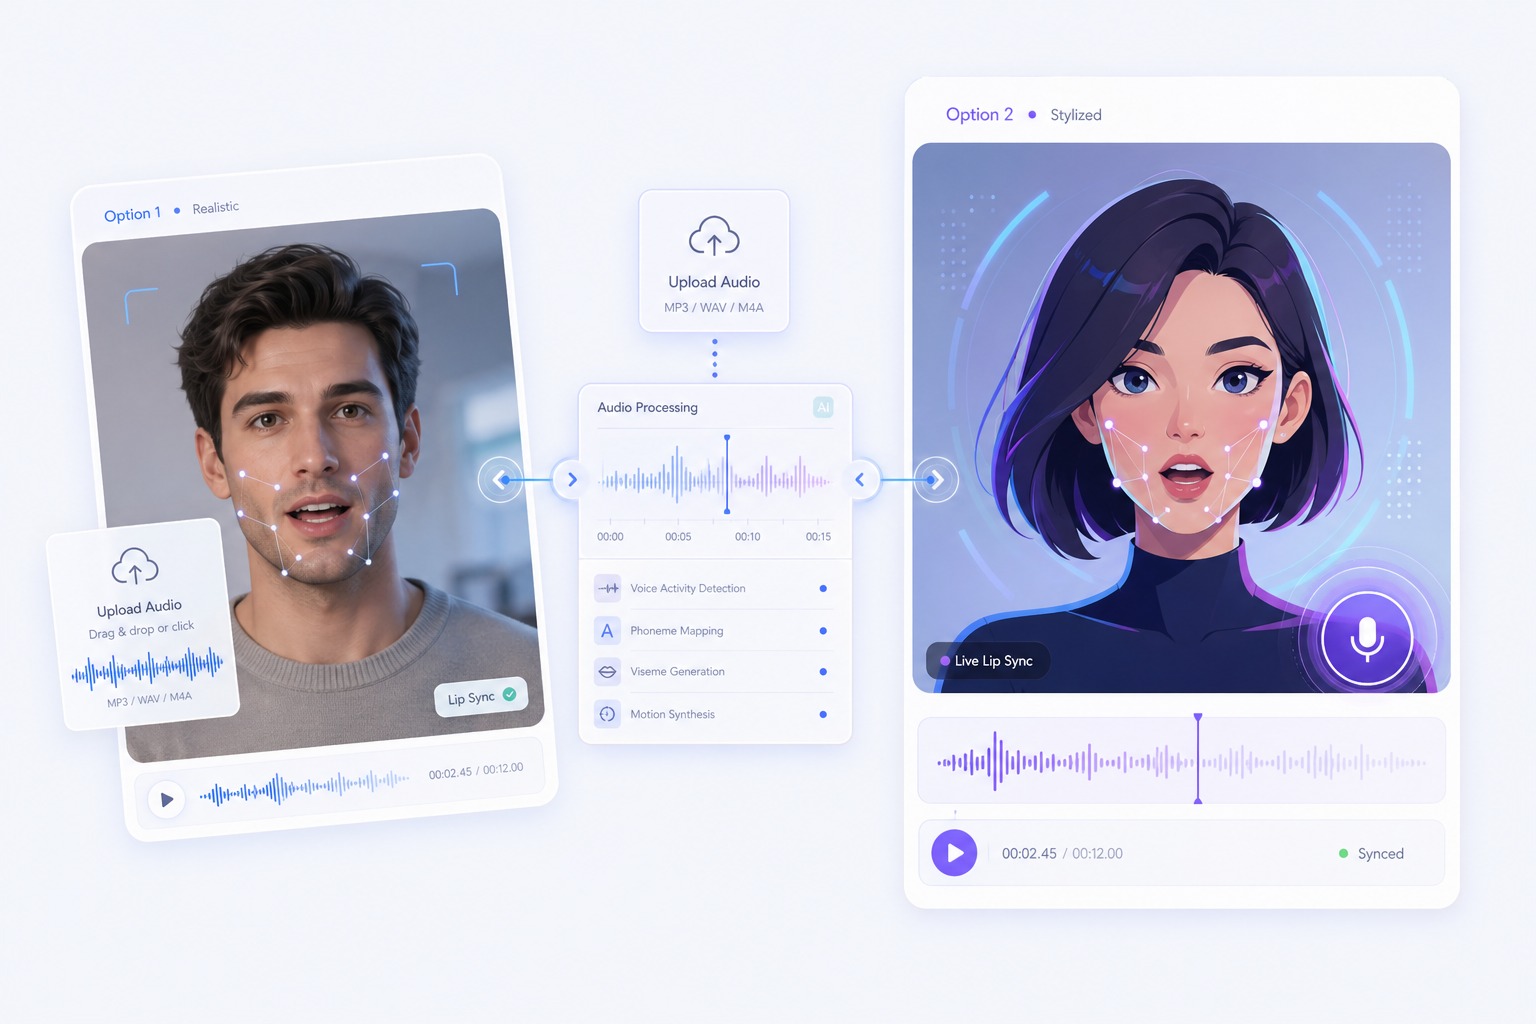
上传一段视频和一条音频,AI 会把出镜者的口型重新对到新的声音上。适合配音、旁白纠错和多语言版本。
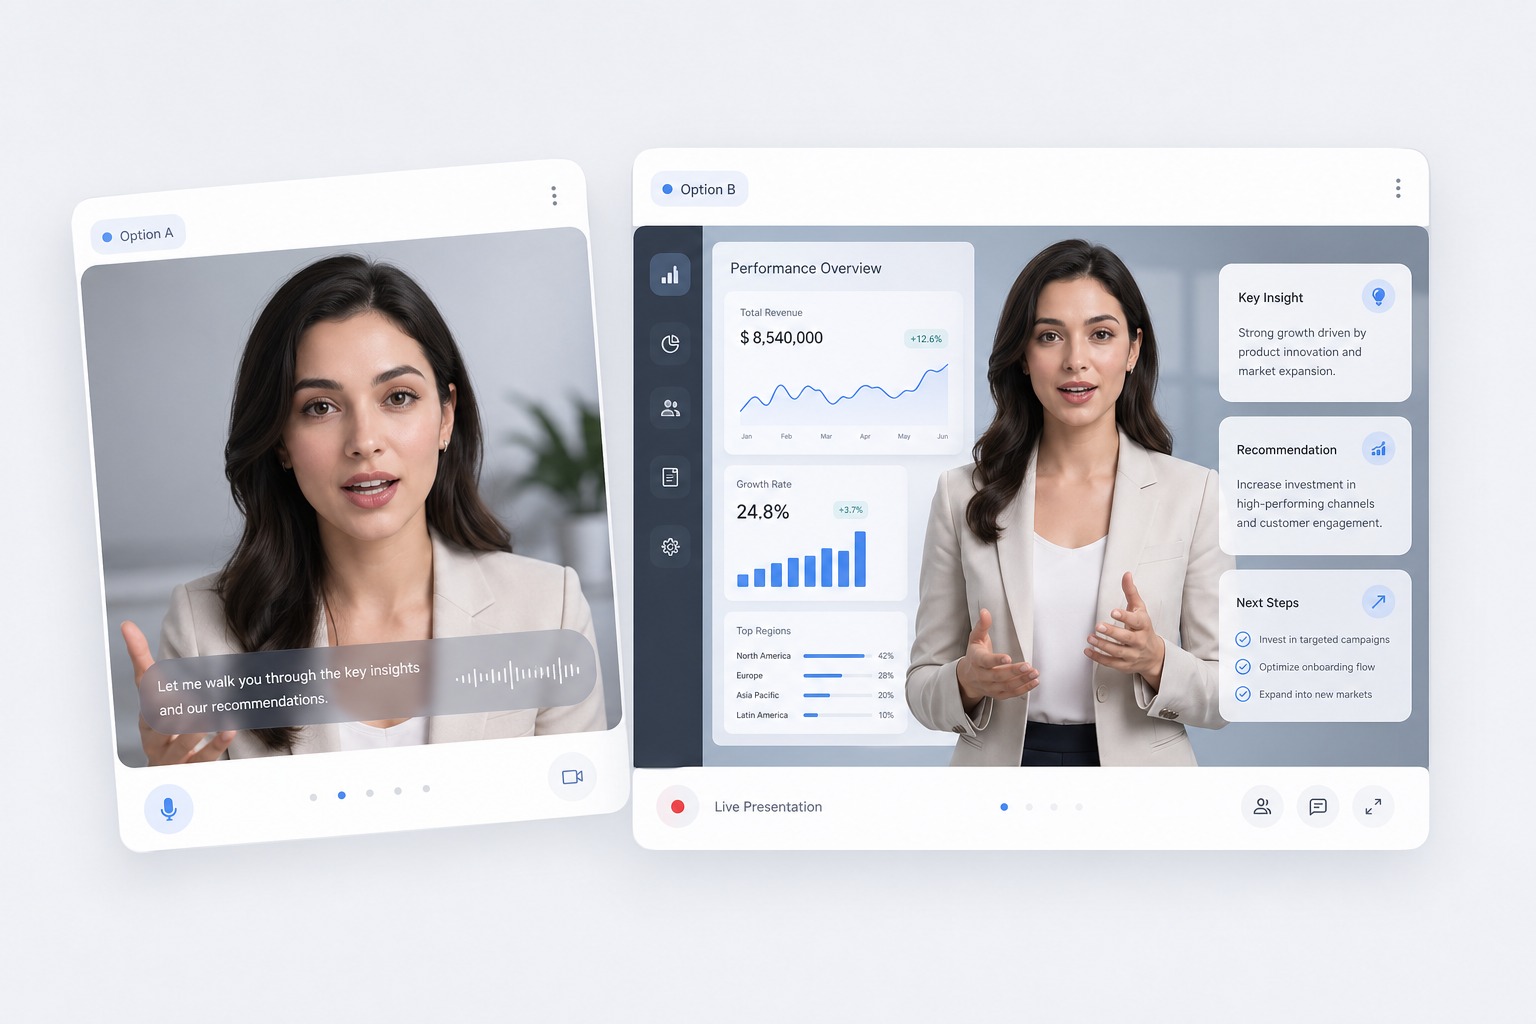
怎样把口型对得更干净
使用场景
AI 口型同步的使用场景
画面本来就合适、只需要换音频的时候用它。
旁白纠错
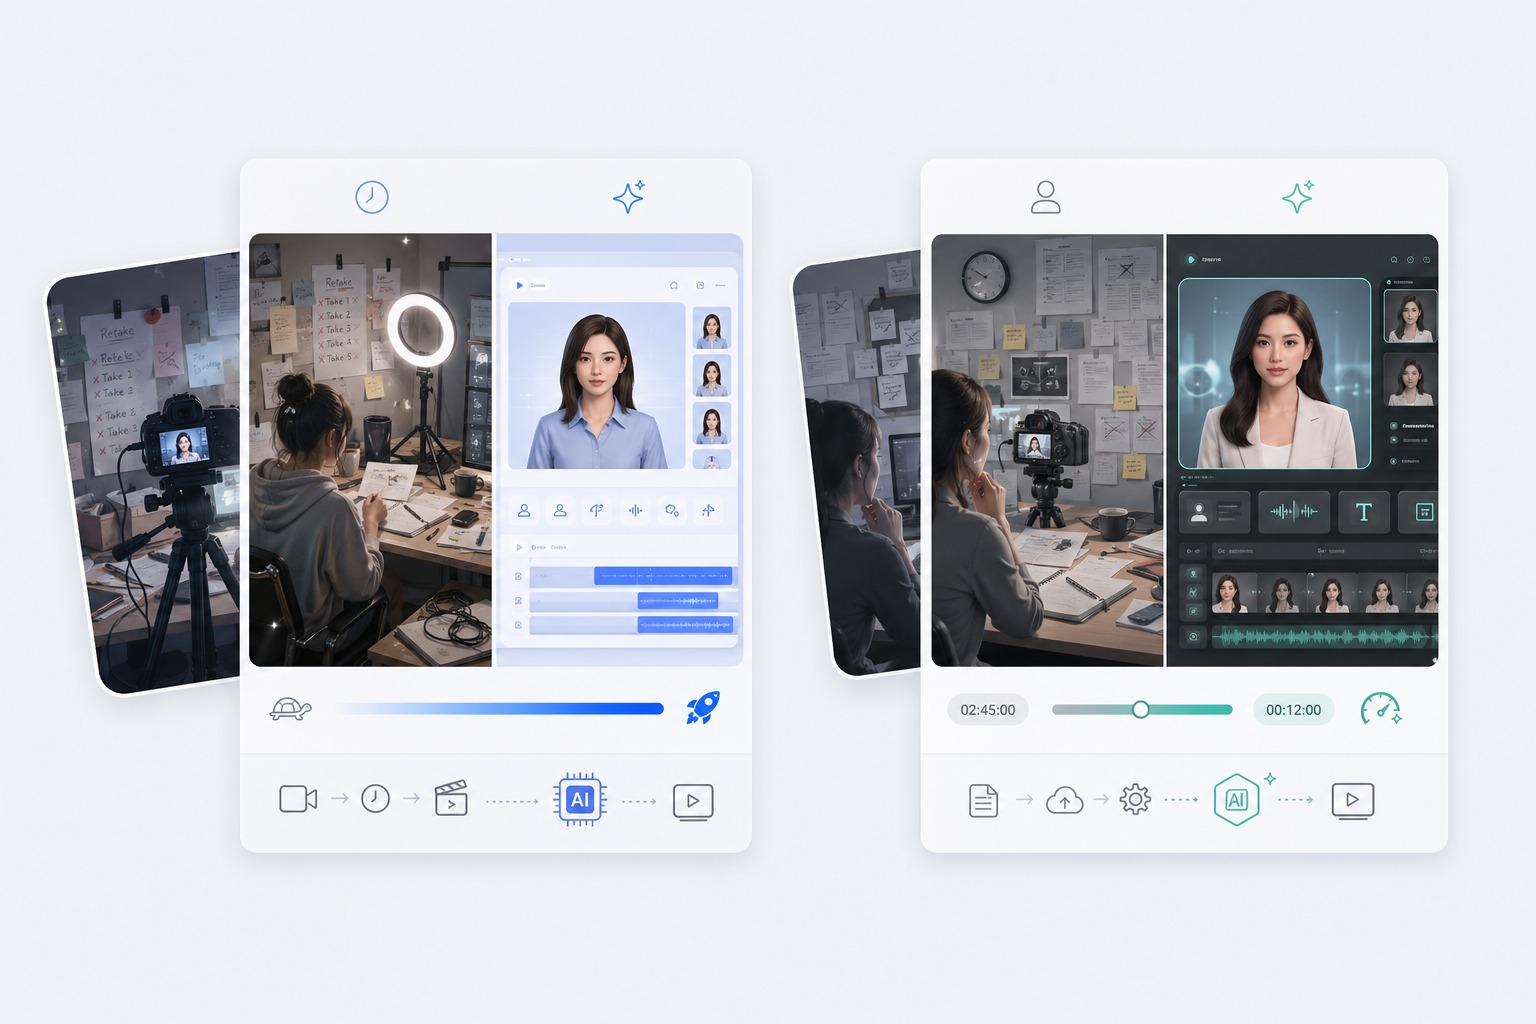
念错的一句话或过时的数字,不用重拍就能改:重录音频,再对回同一条素材。
多语言版本
为新市场准备一条翻译好的配音,每种语言都能沿用同一位出镜者。
社媒二次剪辑
换掉音频而不是重新拍摄,就能把一条片子改成另一场投放或另一个平台的版本。
输入、限制和权利
这个口型同步工具能做什么、不能做什么
视频要求
短边不超过 1080px、大小不超过 300MB 的片段。人脸全程清晰可见的效果最好。
音频要求
至少 1 秒,不超过 100MB。请准备好成品音轨——工具是对上它,而不是生成它。
输出长度
预计输出不超过 120 秒。在 Normal 模式下,长度取视频和音频里较短的那个。
播放模式
Normal 把视频播一遍;Loop 会重复到音频结束。按你音轨的长度选。
一次只处理一条音轨
这套流程把一条音轨对到画面上,不会在同一个场景里区分或分配多个说话人。
画面和声音的权利
只上传你拥有或已获授权使用的视频和音频;真人的声音必须经本人同意才能使用。
怎么用 AI 给视频对口型
三步:素材视频 → 新音频 → 生成
01
上传素材视频
选一段只有一位说话人、人脸清晰可见的片段。短边不超过 1080px,文件不超过 300MB。
02
上传新音频
加上你想让他说的台词、旁白或演唱音轨。最短 1 秒,最大 100MB。
03
选好播放模式再生成
选 Normal 或 Loop,生成之后先检查口型时机再导出。预计输出不超过 120 秒。
创作者为什么用 AI 口型同步
- 保留这条素材,只换说的话: 原来的画面、光线和表演都保持不变,只有口型跟着新音频走。
- Normal 和 Loop 两种播放: Normal 会截掉超出片段长度的音频;Loop 会重复片段直到音轨结束。
- 按输出长度和分辨率计费: 费用取决于你生成的秒数,以及素材视频所在的分辨率档位。
保留这条素材,只换说的话
重拍成本高、而脚本比场景和出镜者变得更频繁时,这种做法很实用。
Normal 和 Loop 两种播放
一小段素材配一条更长的旁白——Loop 就是为这种情况做的。
按输出长度和分辨率计费
音轨越短、素材分辨率越低,生成的花费就越少。
关于用 AvatarCraft AI 制作口型同步视频的常见问题。