—Cost: —
AI 影片對口型
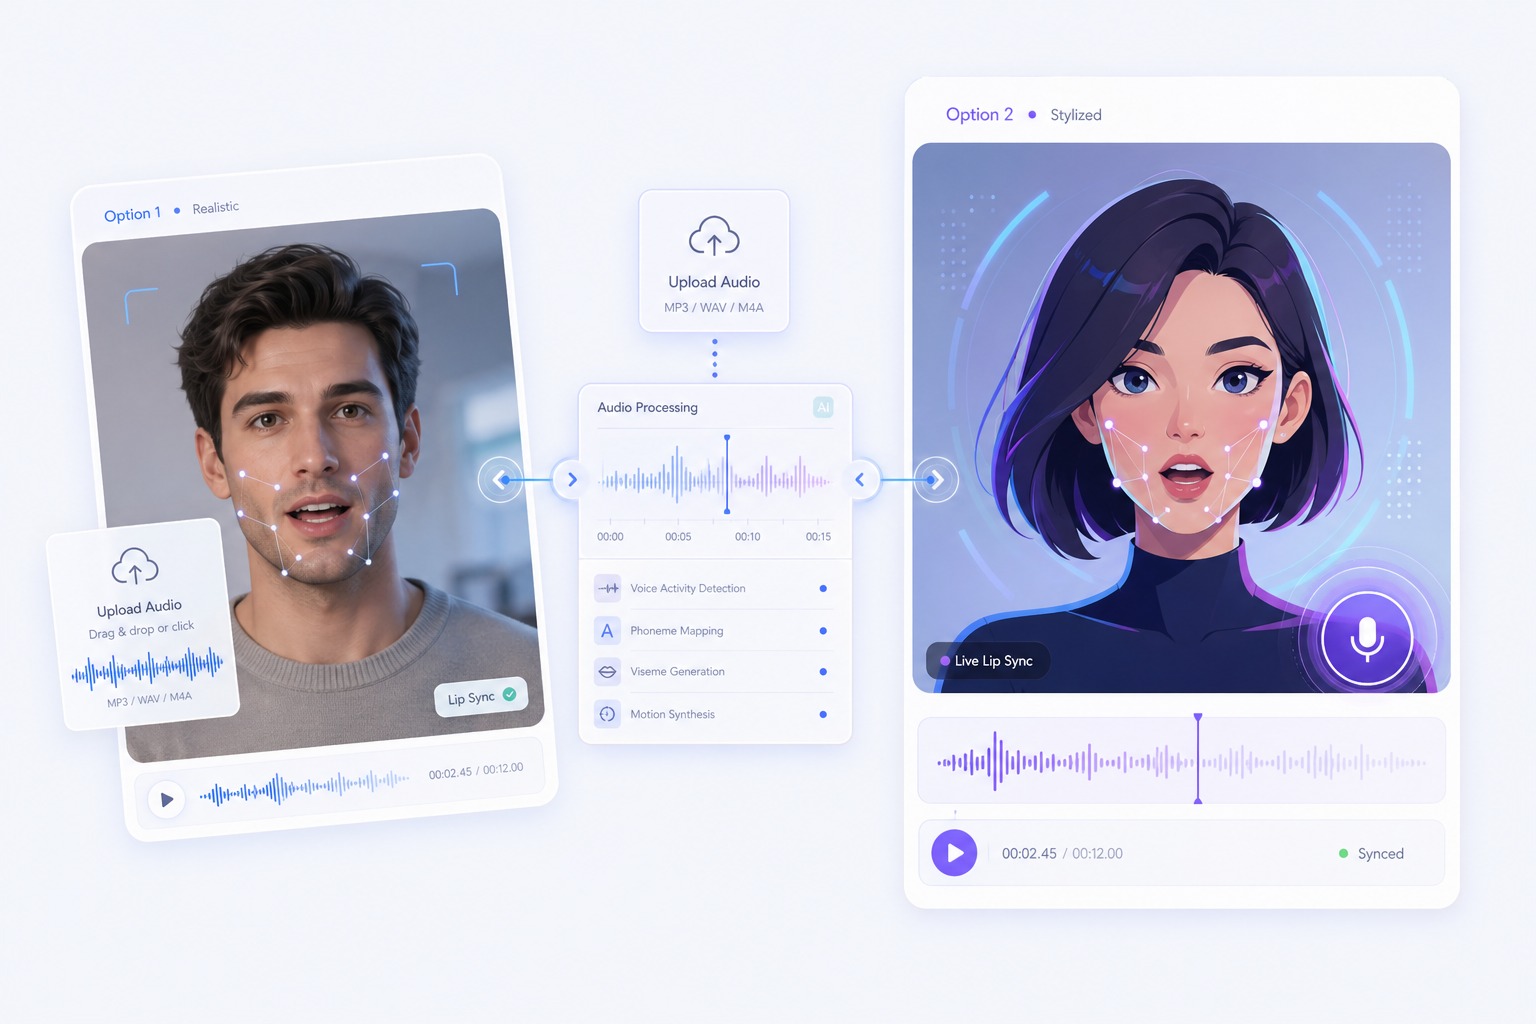
上傳一段影片和一條音訊,AI 會把出鏡者的嘴型重新對到新的聲音上。適合配音、旁白修正和多語版本。
怎樣把嘴型對得更乾淨
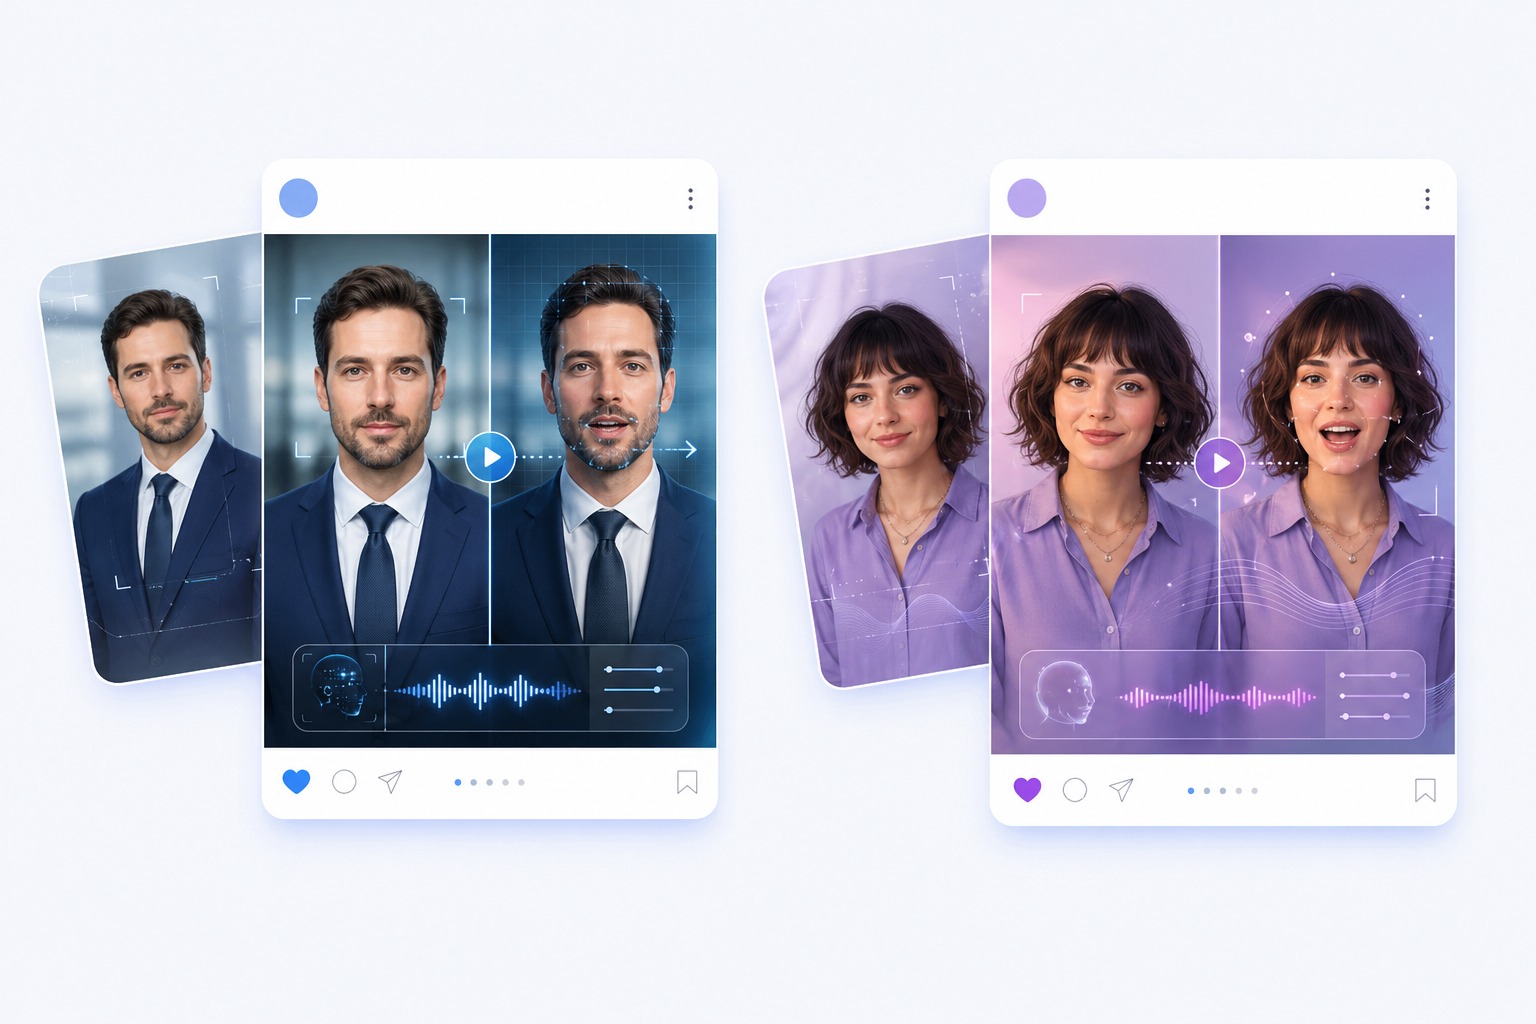
使用情境
AI 影片對口型的使用情境
畫面本來就合適、只需要換音訊的時候用它。
旁白修正
唸錯的一句話或過時的數字,不用重拍就能改:重錄音訊,再對回同一條素材。
多語版本
為新市場準備一條翻譯好的配音,每種語言都能沿用同一位出鏡者。
社群二次剪輯
換掉音訊而不是重新拍攝,就能把一支片子改成另一檔投放或另一個平台的版本。
輸入、限制和權利
這個對口型工具能做什麼、不能做什麼
影片條件
短邊不超過 1080px、大小不超過 300MB 的片段。人臉全程清晰可見的效果最好。
音訊條件
至少 1 秒,不超過 100MB。請準備好成品音軌——工具是對上它,而不是產生它。
輸出長度
預估輸出不超過 120 秒。在 Normal 模式下,長度取影片和音訊裡較短的那個。
播放模式
Normal 把影片播一次;Loop 會重複到音訊結束。按你音軌的長度選。
一次只處理一條音軌
這套流程把一條音軌對到畫面上,不會在同一個場景裡區分或指派多位說話者。
畫面和聲音的權利
只上傳你擁有或已獲授權使用的影片和音訊;真人的聲音必須經本人同意才能使用。
怎麼用 AI 幫影片對口型
三步:素材影片 → 新音訊 → 產生
01
上傳素材影片
選一段只有一位說話者、人臉清晰可見的片段。短邊不超過 1080px,檔案不超過 300MB。
02
上傳新音訊
加上你想讓他說的台詞、旁白或演唱音軌。最短 1 秒,最大 100MB。
03
選好播放模式再產生
選 Normal 或 Loop,產生之後先檢查嘴型時機再匯出。預估輸出不超過 120 秒。
創作者為什麼用 AI 影片對口型
- 保留這條素材,只換說的話: 原本的畫面、光線和表演都保持不變,只有嘴型跟著新音訊走。
- Normal 和 Loop 兩種播放: Normal 會截掉超出片段長度的音訊;Loop 會重複片段直到音軌結束。
- 按輸出長度和解析度計費: 費用取決於你產生的秒數,以及素材影片所在的解析度級距。
保留這條素材,只換說的話
重拍成本高、而腳本比場景和出鏡者變得更頻繁時,這種做法很實用。
Normal 和 Loop 兩種播放
一小段素材配一條更長的旁白——Loop 就是為這種情況做的。
按輸出長度和解析度計費
音軌越短、素材解析度越低,產生的花費就越少。
關於用 AvatarCraft AI 製作對口型影片的常見問題。